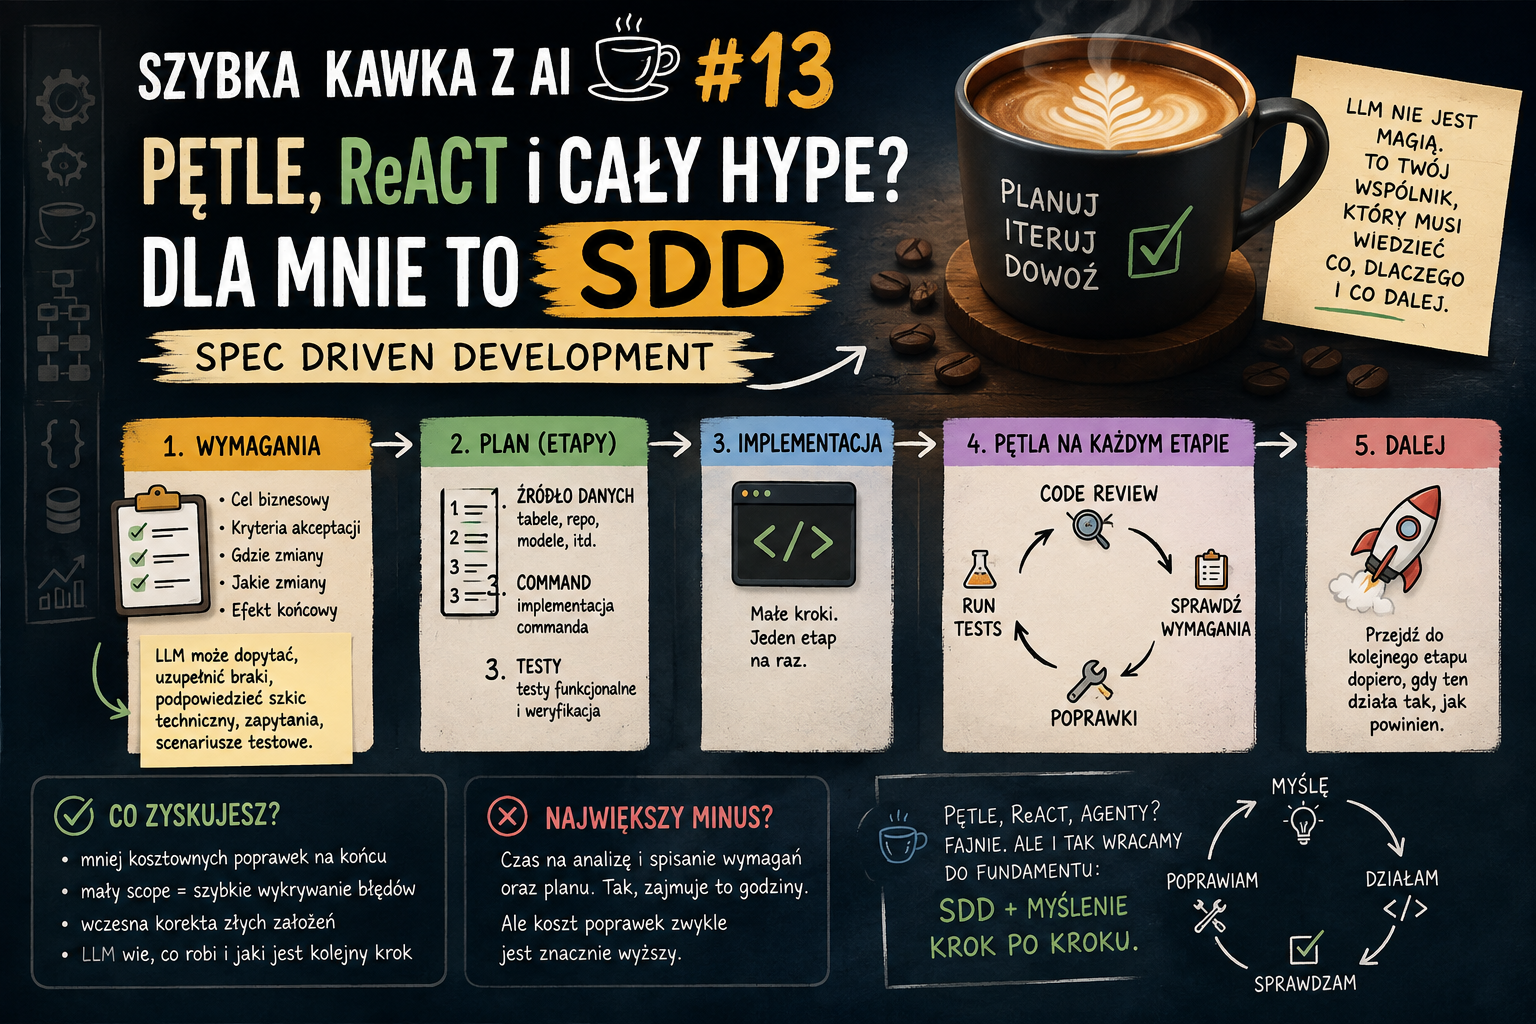
Spec-Driven Development to z jednej strony banalnie prosty temat, a z drugiej można go rozbudować praktycznie w nieskończoność.
Podejść jest sporo. Ja pokażę Ci moje, które wypracowałem na bazie kilku narzędzi i przede wszystkim własnego sposobu pracy.
Bo według mnie właśnie tutaj jest najciekawsza rzecz w SDD.
Nie chodzi tylko o napisanie dobrej specyfikacji. Chodzi trochę o reverse engineering własnego procesu myślenia.
Zastanawiasz się: co zrobiłbym sam, w jakiej kolejności, co sprawdziłbym po drodze i gdzie zatrzymałbym się na review. Potem ten proces przekładasz na instrukcje dla LLM.
Zaczynam od wymagań
U mnie wszystko zaczyna się od przygotowania wymagań.
Traktuję je trochę jak bardzo rozbudowane TODO, które mógłbym przekazać nowemu koledze w zespole.
Powinien z niego zrozumieć:
- jaki jest cel biznesowy,
- jakie są kryteria akceptacji,
- gdzie trzeba wprowadzić zmiany,
- jakie zmiany trzeba wykonać,
- jaki powinien być efekt końcowy.
Nie chodzi o prompt w stylu:
Zrób mi command generujący raport.
LLM powinien dostać możliwie dokładny obraz tego, co właściwie chcemy osiągnąć.
Co ważne, już na tym etapie AI może nam pomóc.
Możemy kazać mu zadawać pytania, szukać brakujących informacji albo przygotować techniczny szkic rozwiązania. Może wskazać potencjalne zapytania, scenariusze testowe czy miejsca w kodzie, które prawdopodobnie będą wymagały zmian.
Nadal jednak to my ustalamy, co właściwie budujemy.
Potem powstaje plan
Kiedy wymagania są gotowe, proszę LLM o przygotowanie planu.
Najlepiej podzielonego na małe etapy.
Weźmy banalny przykład. Budujemy command, który potrzebuje nowego źródła danych.
Plan może wyglądać tak:
Etap 1: źródło danych
Tworzymy tabelę, model, repository i wszystko, czego potrzebujemy do pobrania danych.
Etap 2: command
Implementujemy właściwy command korzystający z przygotowanego wcześniej źródła.
Etap 3: testy
Dodajemy testy funkcjonalne i sprawdzamy cały flow.
I dopiero wtedy zaczynamy implementację.
Każdy etap może być osobną pętlą
I tutaj zaczyna robić się ciekawie.
Bo przecież po każdym etapie możemy powiedzieć LLM (lub zrobić samemu całość/część):
- uruchom testy,
- sprawdź code coverage,
- zrób code review,
- porównaj implementację z wymaganiami,
- popraw znalezione problemy,
- wykonaj code-review zmian,
- dopiero potem przejdź dalej.
Możesz mieć jedną iterację albo pięć. Możesz dodać osobnego agenta do review. Możesz po każdym etapie wymagać konkretnego zestawu testów.
To już Twoja inwencja twórcza.
I właśnie dlatego, kiedy ostatnio widzę coraz więcej dyskusji o pętlach agentów, ReAct i kolejnych workflow, patrzę na to trochę inaczej.
Dla mnie spora część tego sprowadza się do jednego: odtwórz swój własny proces pracy i każ LLM przechodzić przez niego krok po kroku.
Myślisz → działasz → sprawdzasz rezultat → poprawiasz → przechodzisz dalej.
Możemy nazwać to pętlą. Możemy nawiązywać do ReAct. Możemy obudować to kolejnym frameworkiem.
Po co aż tyle zachodu?
Największa korzyść jest prosta: mniej kosztownych poprawek na końcu.
Jeżeli każemy LLM od razu zaimplementować dużą funkcjonalność, może źle zrozumieć jedno założenie na początku i konsekwentnie ciągnąć ten błąd przez kolejne warstwy aplikacji.
Potem zaczyna się:
popraw to
teraz zepsuło się tamto
popraw testy
jednak repository powinno działać inaczej
jeszcze command
i przy okazji zmień pół projektu
Tokeny robią brrr. 💸
Przy pracy etapami scope jest znacznie mniejszy.
Jeżeli LLM popłynie z architekturą już podczas przygotowania źródła danych, możemy zatrzymać go właśnie tam. Nie musimy poprawiać jeszcze commanda, testów i wszystkiego, co zdążył na tym zbudować.
To samo dotyczy błędnych założeń.
Im wcześniej je znajdziemy, tym mniej rzeczy trzeba później łatać.
Jest jednak jeden duży minus
To podejście wymaga czasu.
Przy większej funkcjonalności samo przeanalizowanie problemu, przygotowanie wymagań i rozpisanie sensownego planu potrafi zająć kilka godzin.
I łatwo wtedy pomyśleć:
przecież w tym czasie LLM już dawno napisałby kod.
Pewnie tak.
Pytanie tylko, ile czasu później spędziłbyś na jego poprawianiu.
Aktualnie dla mnie jednym z największych kosztów pracy z AI są kolejne iteracje naprawiania źle zrozumianego problemu.
Dlatego wolę poświęcić więcej czasu przed implementacją i ograniczyć liczbę niespodzianek później.