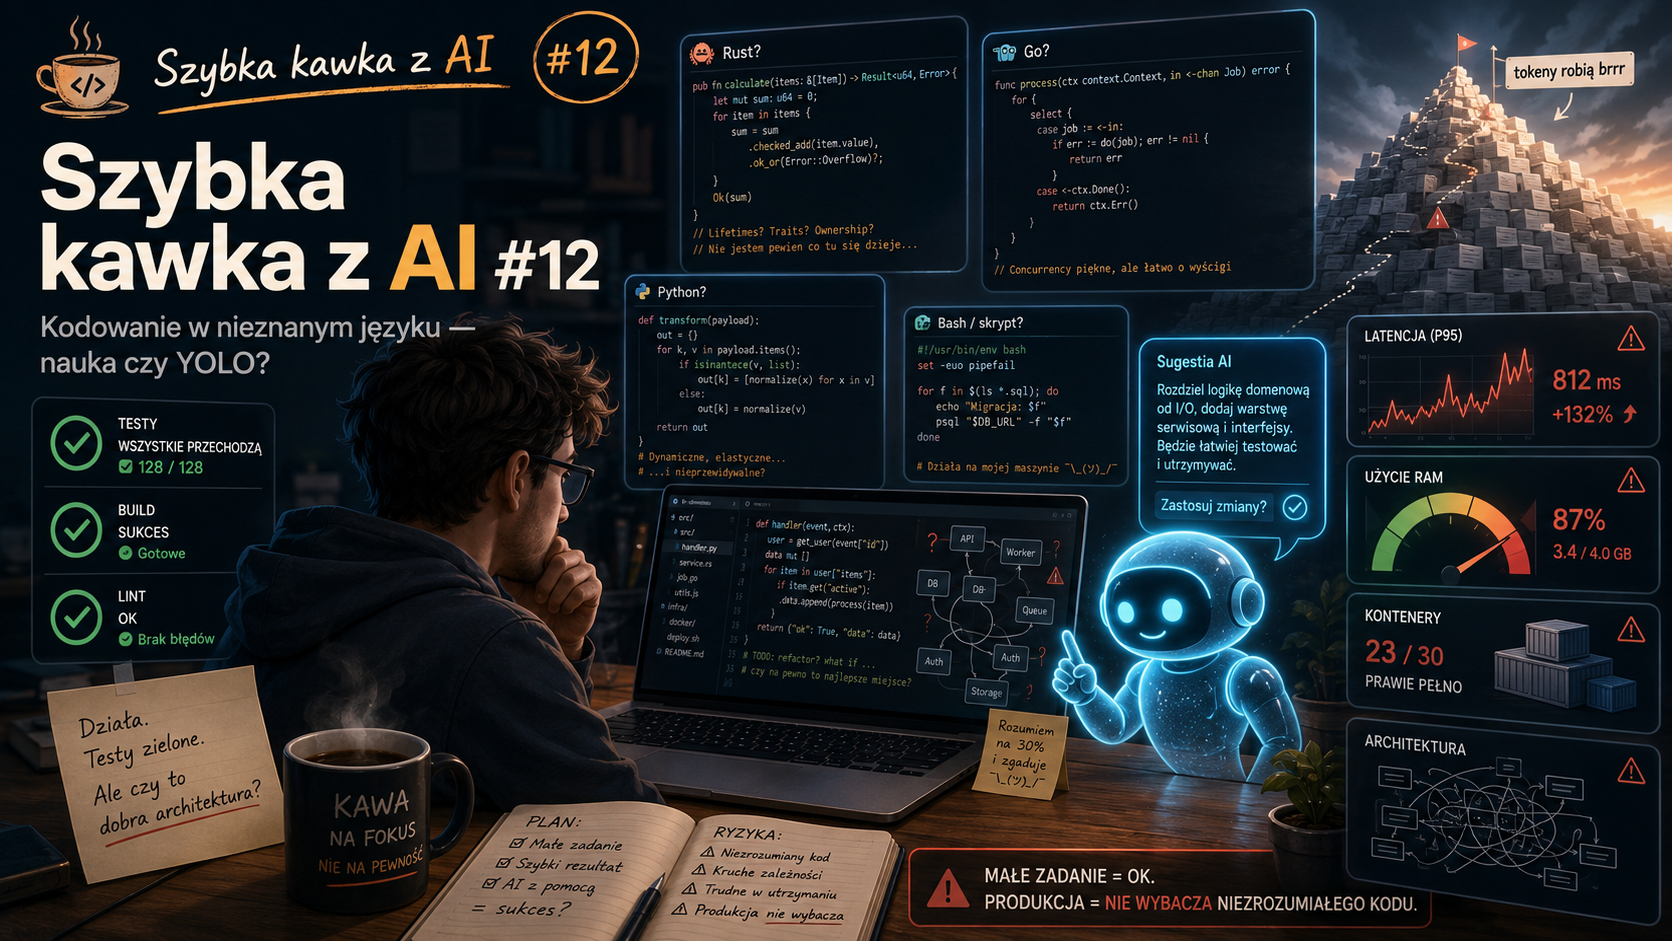
Praca z technologią, której nie znam, to według mnie jedna z najgorszych sytuacji, jakie mogą przydarzyć się developerowi.
A przynajmniej wtedy, gdy kod trafia dalej niż do prostego prototypu.
Aplikacja działa, testy przechodzą, wszystko wygląda sensownie. Problem w tym, że nie do końca wiem:
- dlaczego to działa,
- czy zostało dobrze zaprojektowane,
- gdzie pojawią się problemy,
- czy za miesiąc nadal będę w stanie to rozwijać.
Sam cały czas szukam tutaj złotego środka.
Działa, ale lepiej nie dotykać
Mam cztery projekty stworzone w dużej mierze przez vibe coding. Nie znam dobrze technologii, w których powstały, i nie mam pełnej kontroli nad tym, jak działają.
Czy działają? Tak.
Czy kod jest dobrej jakości? Raczej nie.
Czy chciałbym je teraz rozwijać przez kolejne dwa lata? Zdecydowanie nie.
Na początku wszystko wygląda świetnie. AI szybko dodaje kolejne funkcje, naprawia błędy i rozwiązuje problemy, których sam nie potrafiłbym nawet poprawnie nazwać.
Z czasem zaczyna się jednak klasyczne:
tokeny robią brrr.
Kod rośnie, kontekst puchnie, a każda kolejna zmiana wymaga wczytania połowy projektu. W pewnym momencie dodanie drobnej funkcji zaczyna przypominać wyprawę na Mount Everest.
Testowałem różne zabezpieczenia
Od kilku miesięcy próbuję znaleźć sposób na bezpieczne kodowanie w językach, których nie znam.
Testowałem między innymi:
- dodatkowe code review wykonywane przez AI,
- kilku agentów sprawdzających się nawzajem,
- osobnego agenta zajmującego się architekturą,
- generowanie testów przed implementacją,
- analizowanie każdej zmiany przez kolejny model,
- pętle.
Brzmi sensownie, ale u mnie nadal nie działa tak dobrze, jak powinno.
Problem jest prosty: skoro sam nie znam technologii, nie potrafię dobrze ocenić wyniku review ani zbudować dobrego agenta a agenci od ludzi (mam na myśli skills.sh itp.), najcześciej są po prostu słabi.
Model może napisać, że kod jest świetnie zaprojektowany. Drugi model może się z nim zgodzić. Trzeci dorzucić zielony znaczek.
Tylko co z tego, skoro wszystkie trzy mogły zaakceptować ten sam zły pomysł?
Najpierw nauka, później produkcja
Aktualnie najlepszym rozwiązaniem wydaje mi się po prostu nauczenie się danego języka z pomocą AI.
Nie musisz od razu zostać ekspertem. Musisz jednak rozumieć wystarczająco dużo, żeby:
- ocenić zaproponowaną architekturę,
- zauważyć podejrzane rozwiązanie,
- sprawdzić, czy kod pasuje do standardów danego ekosystemu,
- zadać właściwe pytanie,
- nie akceptować każdej odpowiedzi tylko dlatego, że brzmi profesjonalnie.
O nauce z AI pisałem już w jednej z poprzednich kawek. W jednej z kawek opiszę konkretny przykład tego, jak ostatnio uczę się Rusta.
Dla mnie to dość świeże podejście. W świecie AI rozwiązanie, które dzisiaj działa, jutro może zostać zastąpione czymś skuteczniejszym. Dlatego nadal testuję różne warianty i pewnie ciągle będę testować i szukać.
Mały skrypt to nie system produkcyjny
Oczywiście nie każdy projekt wymaga kilkutygodniowej nauki nowego języka.
Jeżeli muszę rozwiązać mały, zamknięty problem — na przykład przygotować skrypt wysyłający zestaw plików na FTP — jestem w stanie pozwolić AI napisać go w technologii, której dobrze nie znam.
Ryzyko jest ograniczone:
- zakres projektu jest mały,
- działanie łatwo sprawdzić,
- kod można szybko wyrzucić,
- ewentualny błąd nie rozwali kluczowej części systemu.
Problem zaczyna się wtedy, gdy od nieznanego nam kodu uzależniamy produkcję.
Według mnie nie jest to najlepszy pomysł. Z doświadczenia wiem, że prędzej czy później kończy się źle.
Testy nie ochronią przed wszystkim
W jednym z projektów zauważyłem dziwne skoki czasu odpowiedzi na maszynie.
Okazało się, że LLM uznał, iż apkę trzeba skalować. Przy okazji wprowadził jeszcze niewielką zmianę w obrazie Dockera, która spowodowała regres.
Model przygotował nawet test wydajnościowy. Wszystko było zielone i wyglądało super.
Problem w tym, że znałem ten język tylko powierzchownie. Kod i wyjaśnienie brzmiały sensownie, więc zaufałem AI bardziej, niż powinienem. Historia zakończyła się rollbackiem po 10 minutach.
Innym razem model zwiększył ilość dostępnego RAM-u, żeby przykryć rzeczywisty problem. System chwilowo działał lepiej, ale przyczyna nadal istniała.
I właśnie dlatego same testy mi nie wystarczają.
Test może potwierdzić, że kod zwraca oczekiwany wynik. Nie odpowie jednak automatycznie na pytania:
- czy architektura jest rozsądna,
- czy rozwiązanie będzie się skalować,
- czy prawidłowo wykorzystujemy cache,
- czy nie tworzymy ukrytego problemu wydajnościowego,
- czy jedna klasa nie urosła właśnie do ośmiu tysięcy linii.
Testy sprawdzają to, co kazaliśmy im sprawdzić. Nie sprawdzają całego świata.
Oczywiście są biblioteki do complexity, wykrywania tysięczników, do testów wydajnościowych… ale czy bez przeglądu kodu wszystkiego dopilnujemy? Czy bez znajomości kodu wykryjemy wszystkie edge cases a co za tym idzie napiszemy lub karzemy napisać testy poprawnie? Albo czy karzemy poprawnie skonfigurować Rectora, Deptraca czy inne narzędzie? Według mnie nie.
Produktywność za wszelką cenę?
Ostatnio widziałem wypowiedź Uncle Boba Martina, który stwierdził, że nie sprawdza kodu generowanego przez AI, ponieważ zabiłoby to jego produktywność. Zamiast tego opiera się na testach.
Rozumiem to podejście, ale osobiście mu nie ufam.
Jeżeli testy przygotował człowiek dobrze znający system, sytuacja wygląda znacznie lepiej. Nadal jednak testy nie powiedzą nam wszystkiego o utrzymywalności kodu, architekturze czy kosztach jego dalszego rozwoju.
Możemy mieć sto procent zielonych testów i jednocześnie stworzyć potwora, którego każda kolejna zmiana będzie kosztowała sto dolarów, bo model musi najpierw wczytać cały Mount Everest kontekstu.
Masz dwie drogi
Na ten moment widzę dwie możliwości.
Pierwsza to spokojna droga: poświęcasz czas na naukę języka, poznajesz podstawy jego ekosystemu i dopiero wtedy wykorzystujesz AI jako wsparcie.
Druga to YOLO: generujesz kod, odpalasz testy i liczysz, że wszystko będzie dobrze.
W małym, jednorazowym projekcie druga opcja może mieć sens. Przy większej skali prędzej czy później przestanie się opłacać albo produkcja padnie i nikt nie będzie w stanie tego naprawić.
AI pozwala napisać kod w praktycznie dowolnym języku.
Nie oznacza to jednak, że pozwala bezpiecznie utrzymywać system, którego nie rozumiesz.